О чем материал
Рассуждаем, как можно оценить ущерб от инцидента и проверить эффективность работы SOC
SOC — это значительная инвестиция в ИБ. Чтобы он заработал, нужно потратить довольно большие средства. А чтобы SOC продолжал работать, их нужно тратить постоянно. Но какой эффект от этого в итоге получит бизнес? Этим вопросом задается каждый CISO, равно как и другие руководители, владельцы и стейкхолдеры. Казалось бы, если SOC работает, но ничего не происходит, значит, все хорошо? Значит, защитники не зря едят свой хлеб? Однако у менеджмента часто возникает вопрос: «А если вкладывать в ИБ меньше, может быть, и этого будет достаточно? И тоже ничего не будет происходить?»
Очевидно, что для доказательства полезности SOC необходимы метрики. Давайте разбираться, какие именно.
Почему стандартные метрики не помогают бизнесу
Метрики SOC делятся на тактические, операционные и стратегические — в зависимости от того, на решения какого уровня они влияют. Стандартные метрики обычно относятся к операционному уровню управления:
- количество инцидентов за смену;
- время взятия в работу — сколько инцидент ждал, пока им займется специалист;
- время реагирования — сколько прошло от начала до завершения реагирования;
- процент покрытия ИТ-активов мониторингом — сколько хостов подключено к SIEM, DLP, антивирусу и пр.;
- процент соблюдения SLA — например, сколько инцидентов закрыто быстрее норматива.
Почему эти метрики плохо отражают полезность SOC? Потому что они показывают, как он работает, но не конечный результат этой работы. Возьмем, к примеру, количество инцидентов за смену. Повышение показателя относительно прошлого периода может говорить о том, что идет атака. Либо о том, что включились новые правила мониторинга или же подключились дополнительные источники событий. В итоге непонятно, случилось много маленьких инцидентов или один большой...
Еще одна проблема: такие метрики не позволяют приоритизировать инциденты. Аналитики (или же ИИ-агенты) быстро хватают алерты из очереди и реагируют. На первый взгляд, SOС работает как часы. Но действительно ли он обнаруживает то, что важно для бизнеса?
Проще говоря, кроме операционных, нам нужны метрики, которые будут понятны и наглядны для бизнеса. Равно как и для водителя машины важны не только спидометр и показатель уровня бензина в баке, но и навигатор, который подскажет, когда автомобиль достигнет цели.
[!IMPORTANT] Метрики и их показатели, по которым нельзя сказать, «хорошо» это или «плохо» и что с этим делать, — бесполезны.
Метриками полезности SOC могут быть показатели, которые покажут снижение влияния инцидентов на деятельность организации, то есть снижение ущерба. Соответственно, для оценки эффективности нужно хотя бы примерно представлять ущерб от инцидента. Во-первых, его денежный эквивалент (там, где это возможно). Во-вторых, функциональный, который укажет, какие системы, серверы и рабочие станции и как долго были затронуты, были ли скомпрометированы учетные записи и т. д. Чтобы классифицировать инциденты, мы можем связать их с аппетитом к риску или недопустимым событием (НС).
Аппетит к риску и недопустимые события
На простой вопрос «А сколько вы можете позволить себе потерять?» организации могут отвечать по-разному, например:
- «У нас в бухгалтерии есть понимание уровня потерь (1–2% от выручки, 3–5% от прибыли до налогов)».
- «В нашем портфеле на подобные кейсы заложено 15% операционных рисков».
- «Нисколько!»
В первых двух случаях мы имеем дело с конкретной цифрой. В последнем ее можно получить после несложного обсуждения с менеджментом бюджетов, необходимых для сокращения таких потерь до нуля (спойлер: никто не готов столько тратить).
Концепция недопустимых событий используется ровно для той же цели, но с оговоркой: она относится к ИБ.
[!IMPORTANT] Недопустимое событие — это событие, возникшее в результате кибератаки, которое делает невозможным достижение операционных/стратегических целей организации или приводит к значительному нарушению ее основной деятельности.
Недопустимые события обязательно должны быть конкретными: не просто «прерывание логистики», а где и на какой срок. Это позволит привязать недопустимое событие к аппетиту к риску с помощью оценки ущерба (спойлер: мы не можем оценить ущерб от прерывания отгрузок «насовсем», а вот от их прерывания на 2 дня — можем). Таким образом, мы можем оценить любой инцидент с точки зрения простоя процесса, кражи денег, кражи/порчи данных — то есть с точки зрения ущерба.
Логика оценки ущерба
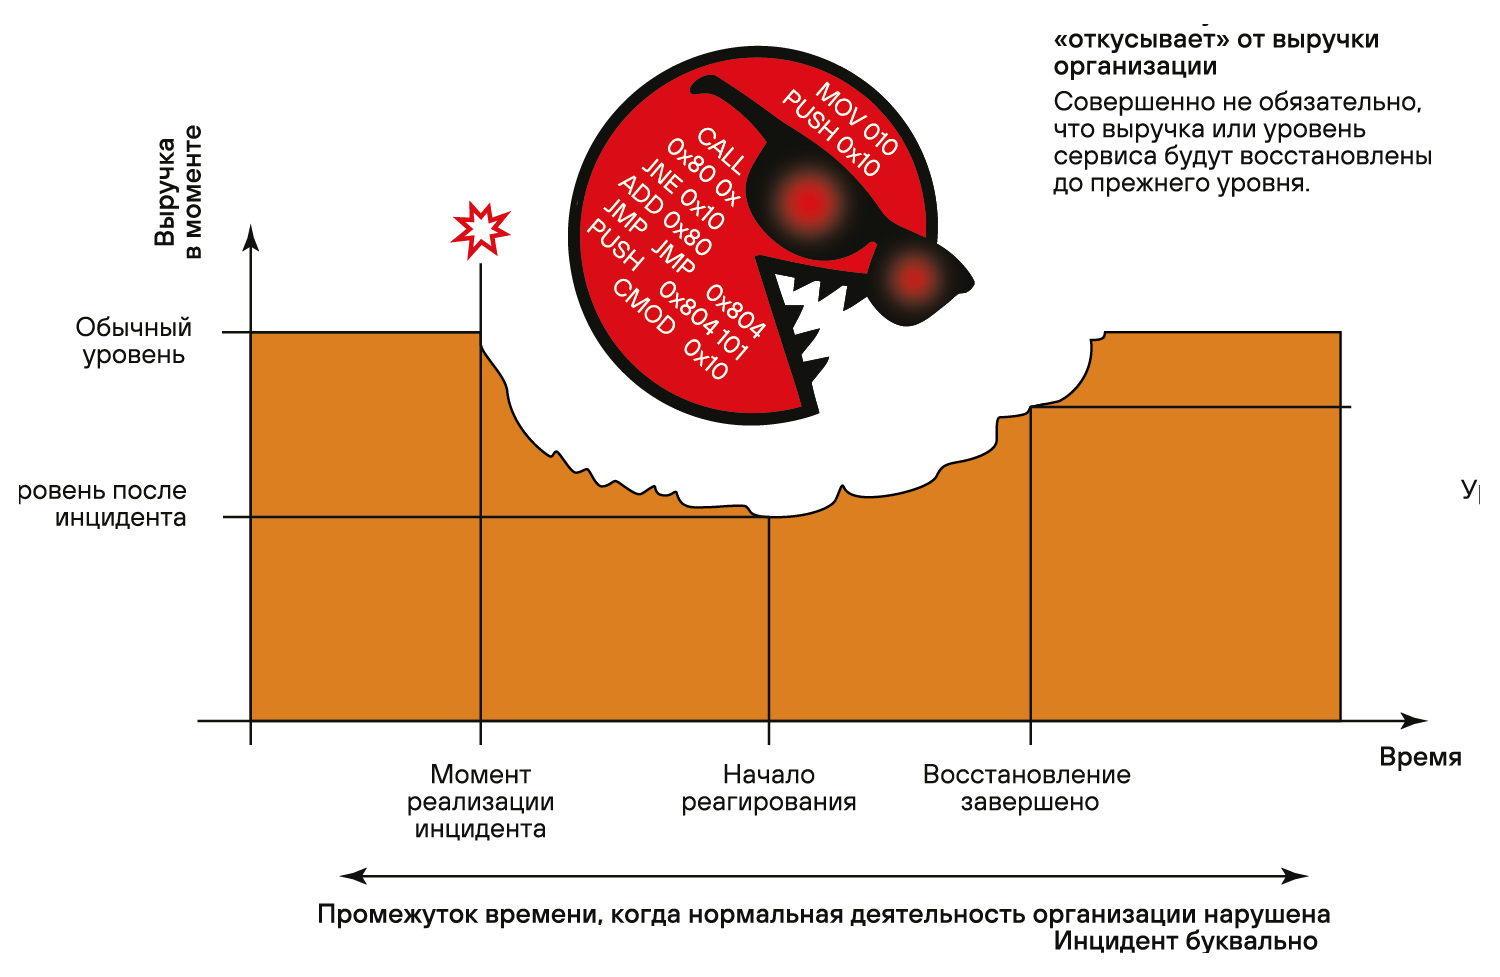
Наибольший ущерб компаниям приносят простой или нарушение нормальной деятельности. Например, если у торговой сети зашифрованы серверы системы управления складом, то отгрузка невозможна. Чем дольше длится простой, тем больше «откусывается» от денег компании (см. рис. 1). Причем, кроме прямого ущерба, связанного с недополученной выручкой или непредоставленными услугами, потери от инцидента могут, к примеру, включать штрафы регуляторов и отток клиентов (который повлечет дополнительные расходы на обратное привлечение).
Дополнительная проблема заключается в том, что недоступность одной системы часто провоцирует каскадный эффект из-за сложных зависимостей. Иногда элементы инфраструктуры могут работать без поддерживающих систем: например, склад может отгружать товары вручную, но медленно и не бесконечно. Кроме того, в условиях плохой инвентаризации активов характер зависимостей и само их наличие могут быть неизвестны организации (в чем я нередко убеждался на практике).
Короче простой — меньше потери
Рассмотрим два сценария реагирования.
Сценарий 1: медленный
- Начали реагировать поздно, реагируем медленно.
- Больший объем ущерба.
- Штрафы регуляторов.
- Уход клиентов.
- Требуется существенный объем усилий по восстановлению.
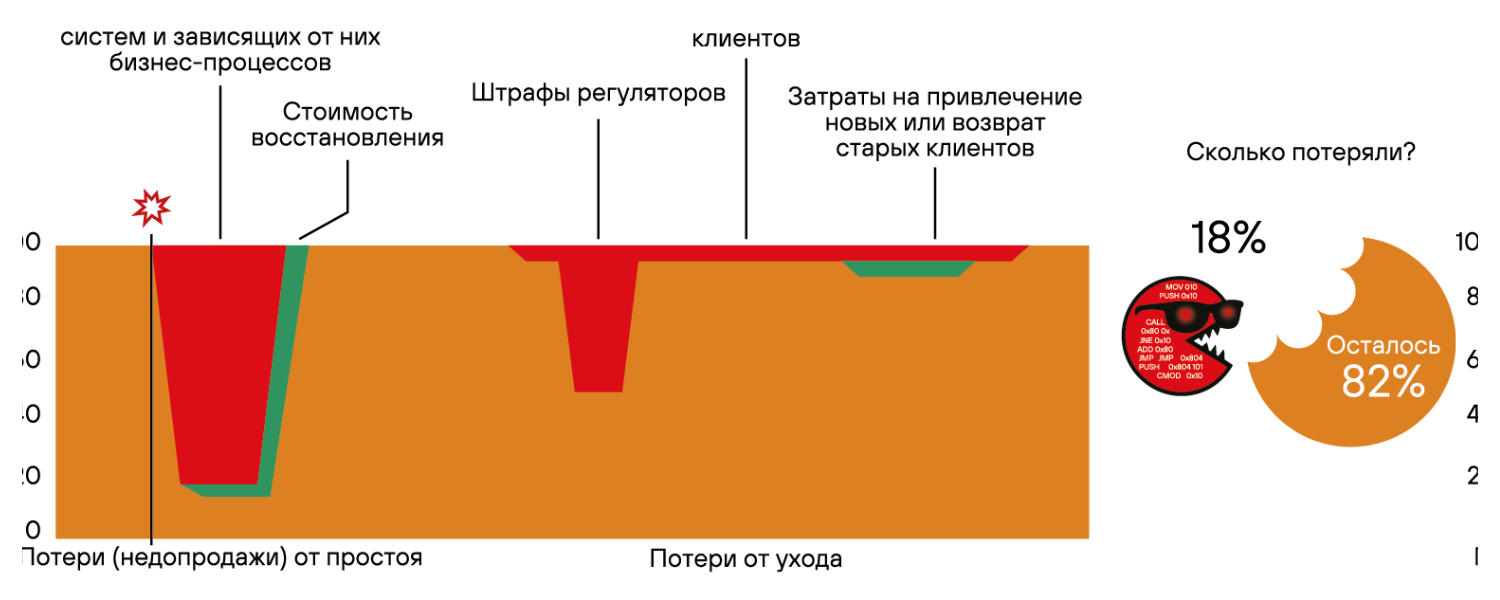
По оси X откладываем время, по оси Y — уровень сервиса/выручку в единицу времени. Для подсчета потерь вычитаем из объема общей выручки или сервиса за период времени (закрашено желтым) площадь, соответствующую падению уровня сервиса (красное и зеленое).
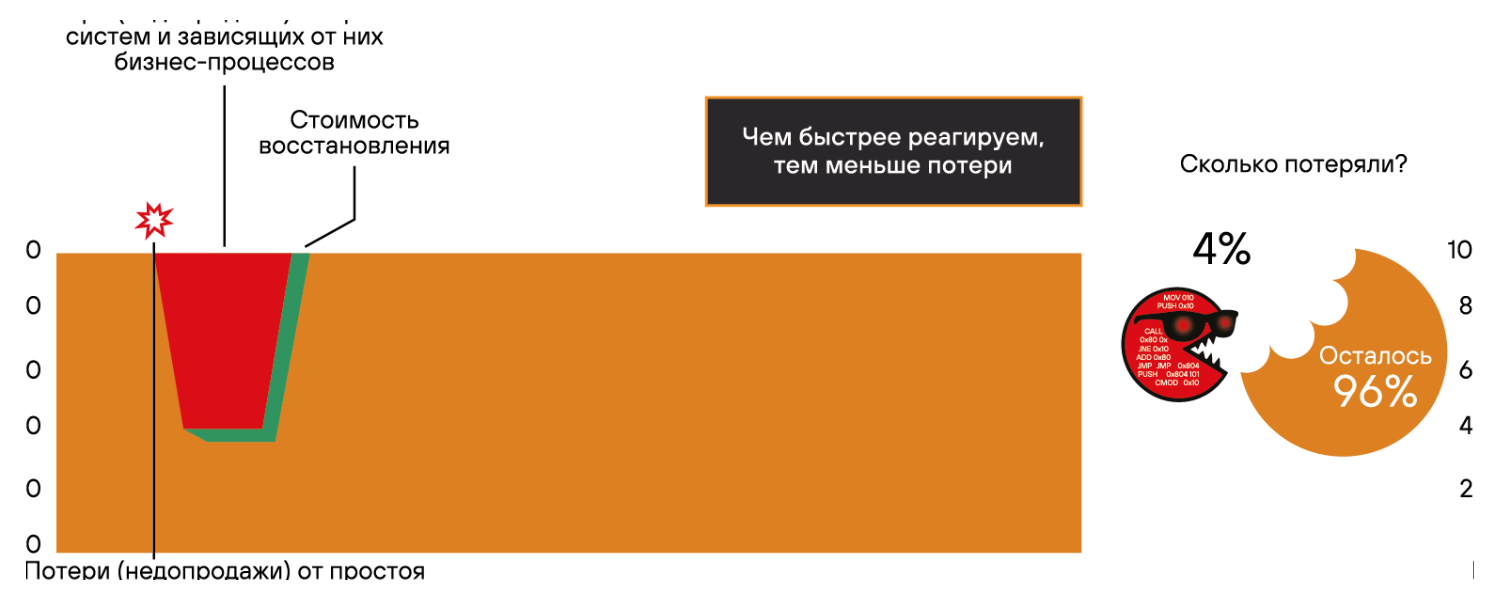
Сценарий 2: быстрый
- Начали реагировать, пока ущерб не достиг большого значения.
- Успели восстановить деятельность организации до момента нарушения требований регуляторов.
- Требуется небольшой объем усилий по восстановлению.
А можно ли точно рассчитать потери?
«Можно, а зачем?» — этот интернет-мем довольно точно передает суть вопроса. ИТ-инфраструктуру и завязанные на нее процессы можно описать математической моделью, в которой воздействие на отдельную систему или ее компонент распространяется с некоторым затуханием и с задержками во времени. В коммерческих организациях можно проанализировать денежные потоки, связанные с продуктами и сервисами; установить связь с процессами, реализующими сервисы или продукты; выяснить, какие системы поддерживают эти процессы; из чего эти системы состоят, на какой ИТ-инфраструктуре работают и т. д. Получится граф, вершинами которого будут процессы, системы, продукты и пр., а ребрами — зависимости, имеющие разную силу и временные характеристики.
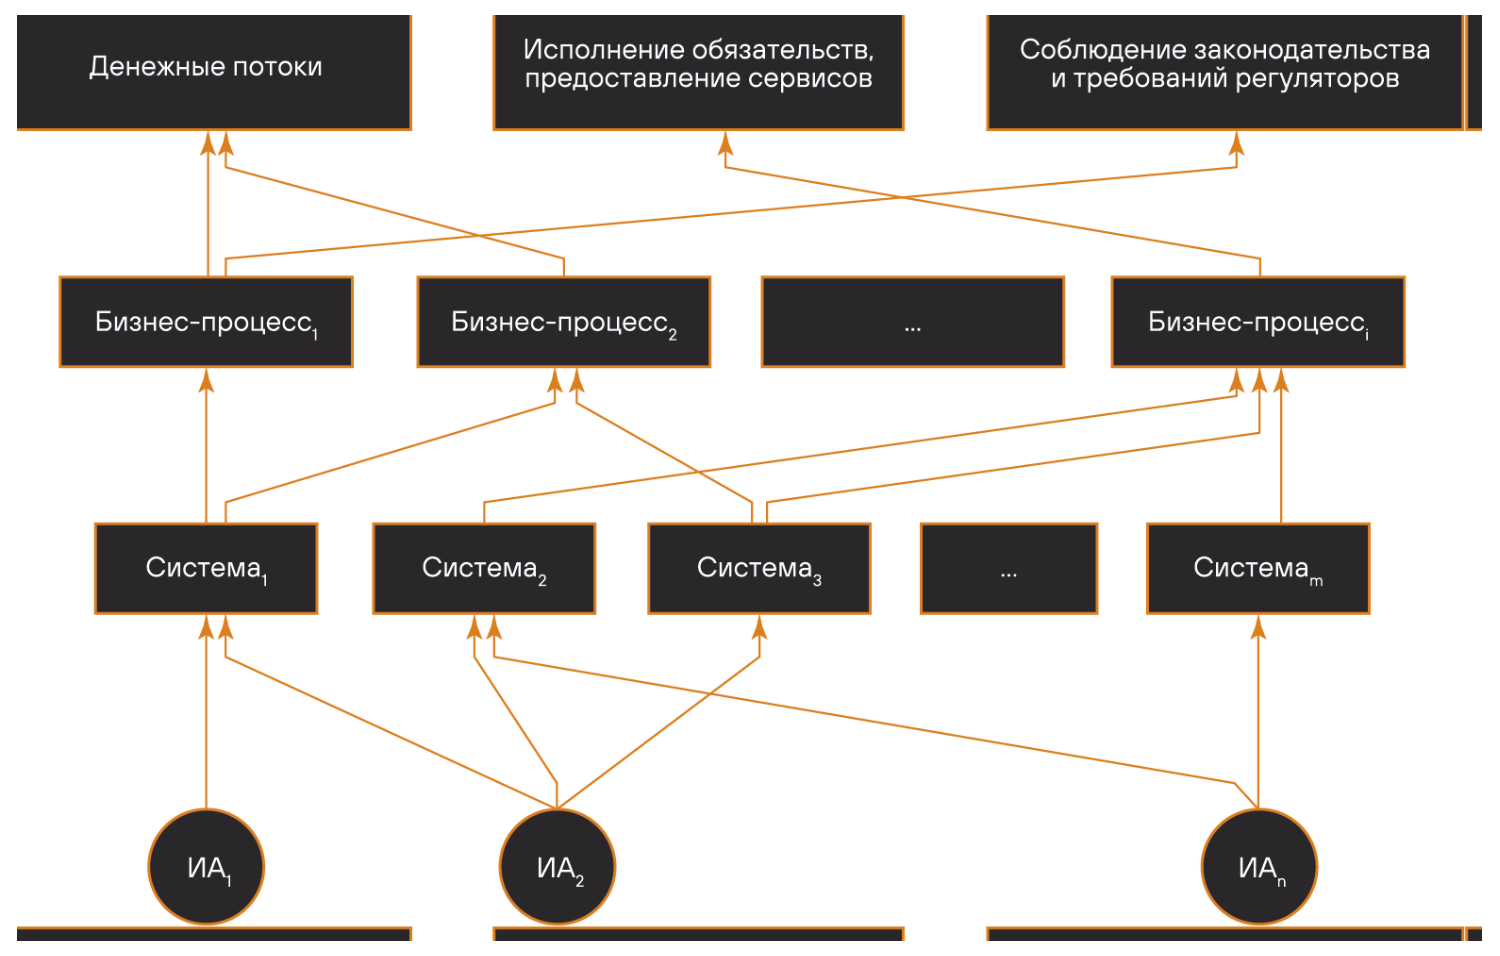
Исходные данные для проведения такого анализа уже есть во многих организациях, а недостающие можно добыть в рамках интервью с представителями ИТ и бизнеса. Трудоемкость этой модели высока, она быстро устаревает, однако ее можно упростить, перейдя от количественных оценок ущерба (например, продаж продукта или услуги) к качественным — диапазонам потерь с верхней и нижней границами. А для процессов можно провести анализ воздействия на бизнес (BIA, Business Impact Analysis). Так мы получим упрощенную картину нарастания потерь и сможем спроецировать их на связанные системы.
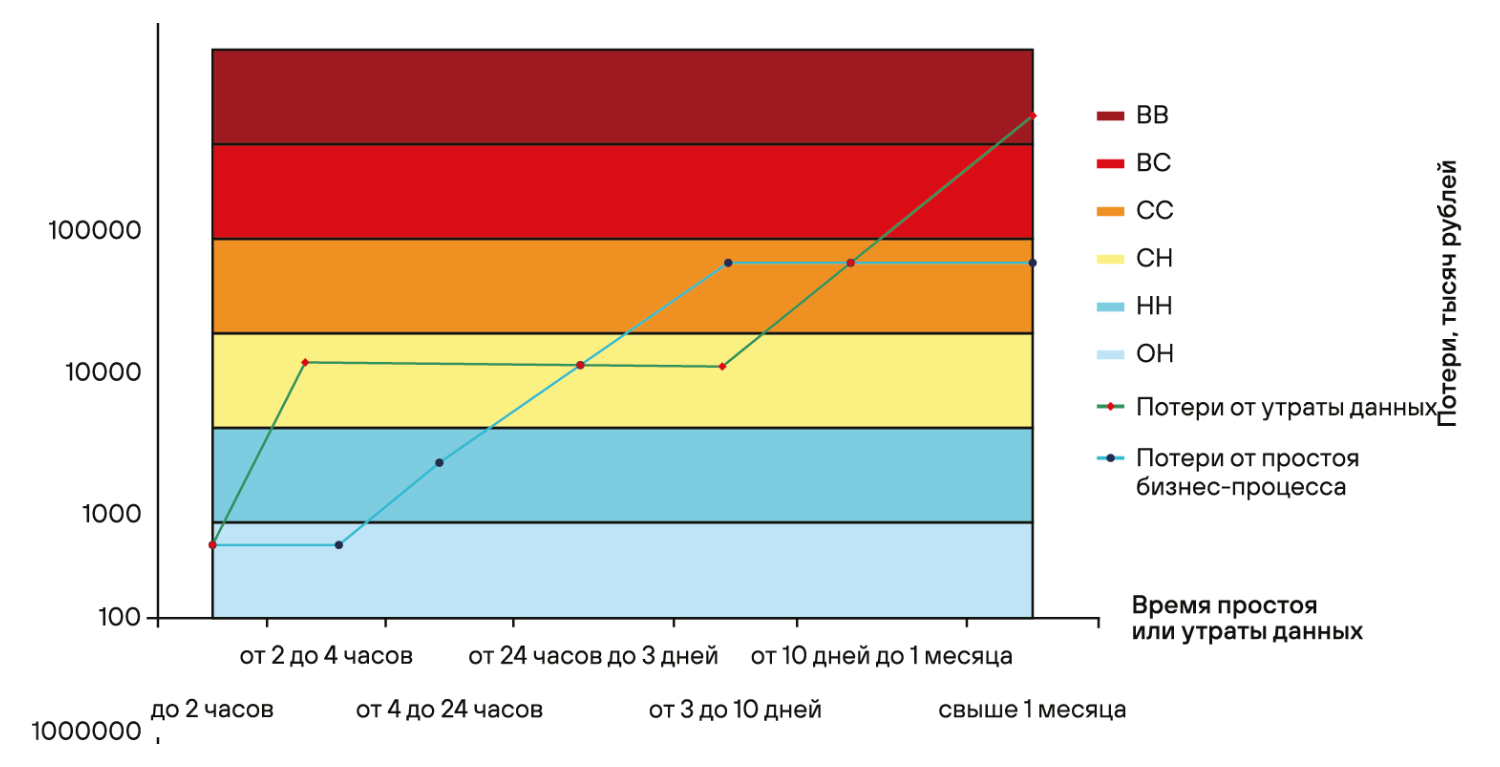
И все равно это довольно сложно: подход требует активного участия со стороны бизнеса и ИТ. Отнюдь не все компании могут позволить себе тратить время на такой (однократный, в общем-то) анализ. Возникает вопрос: а можно как-то проще? Да, можно!
Как определить критичность системы
Начнем с того, что во многих организациях уже есть понятие критичности систем. Широко распространено деление на следующие классы (см. рис. 6).
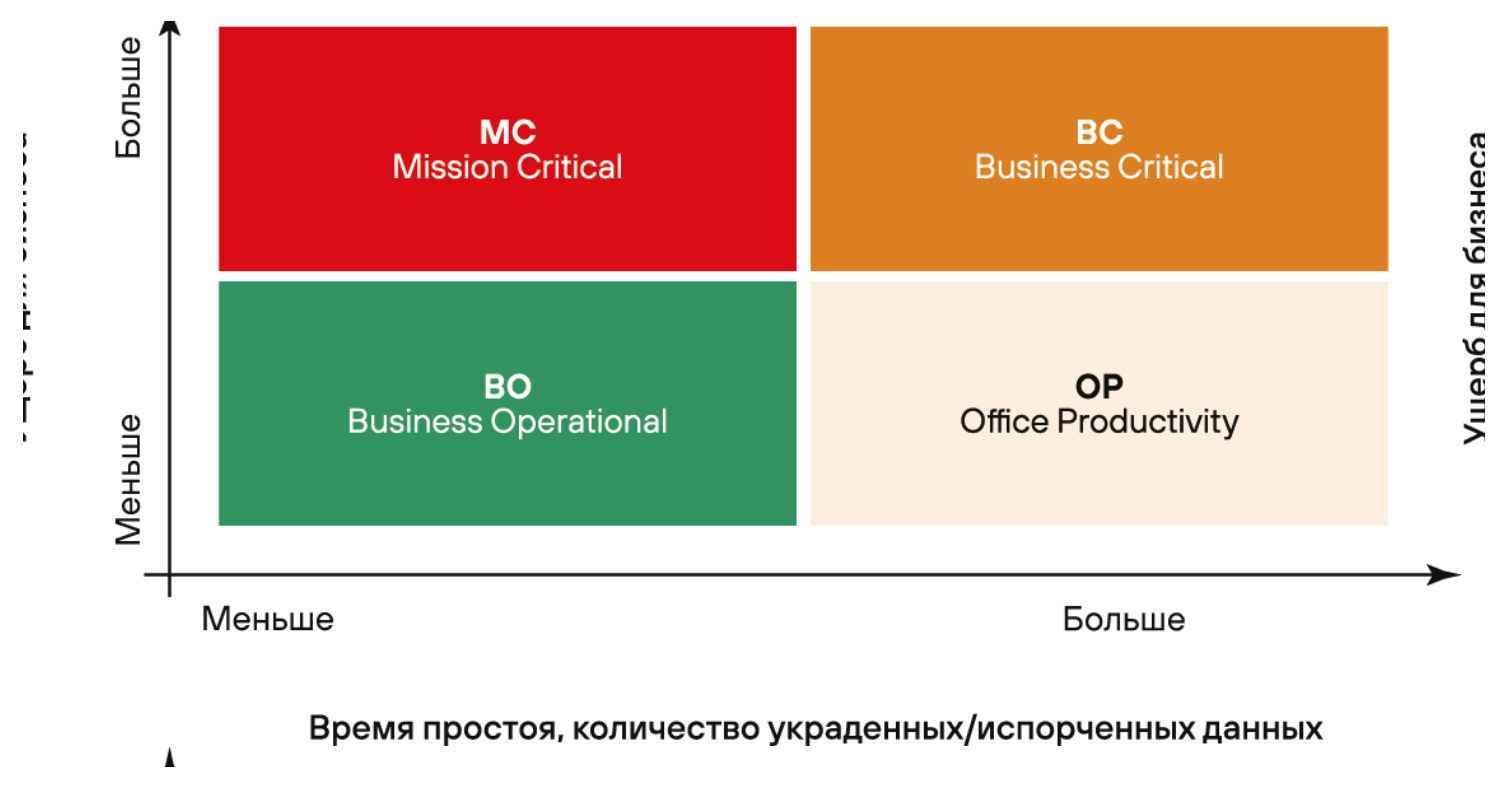
Иногда к ним также добавляют класс Core, соответствующий критической ИТ-инфраструктуре. Эти классы нужны для:
- определения приоритетов восстановления;
- определения стандартизированных ИТ- и ИБ-решений — например, в части применяемых средств и политик защиты (чем критичнее система, тем больше защиты).
[!IMPORTANT] Если вдуматься, то критичность — это скорость нарастания потерь.
Чтобы определить критичность системы, можно воспользоваться следующим алгоритмом (см. таб. 1).
| # | Расшифровка | Пример системы или критерий |
| MC | Mission Critical |
|
| BC | Business Critical |
|
| BO | Business Operational |
|
| OP | Office Productivity |
|
Для определения критичности системы можно задаться простым вопросом: что случится, если она будет недоступна? Каков будет уровень ущерба через час, четыре часа, сутки? По сути, мы пользуемся методикой, похожей на BIA, но в сильно сокращенном варианте.
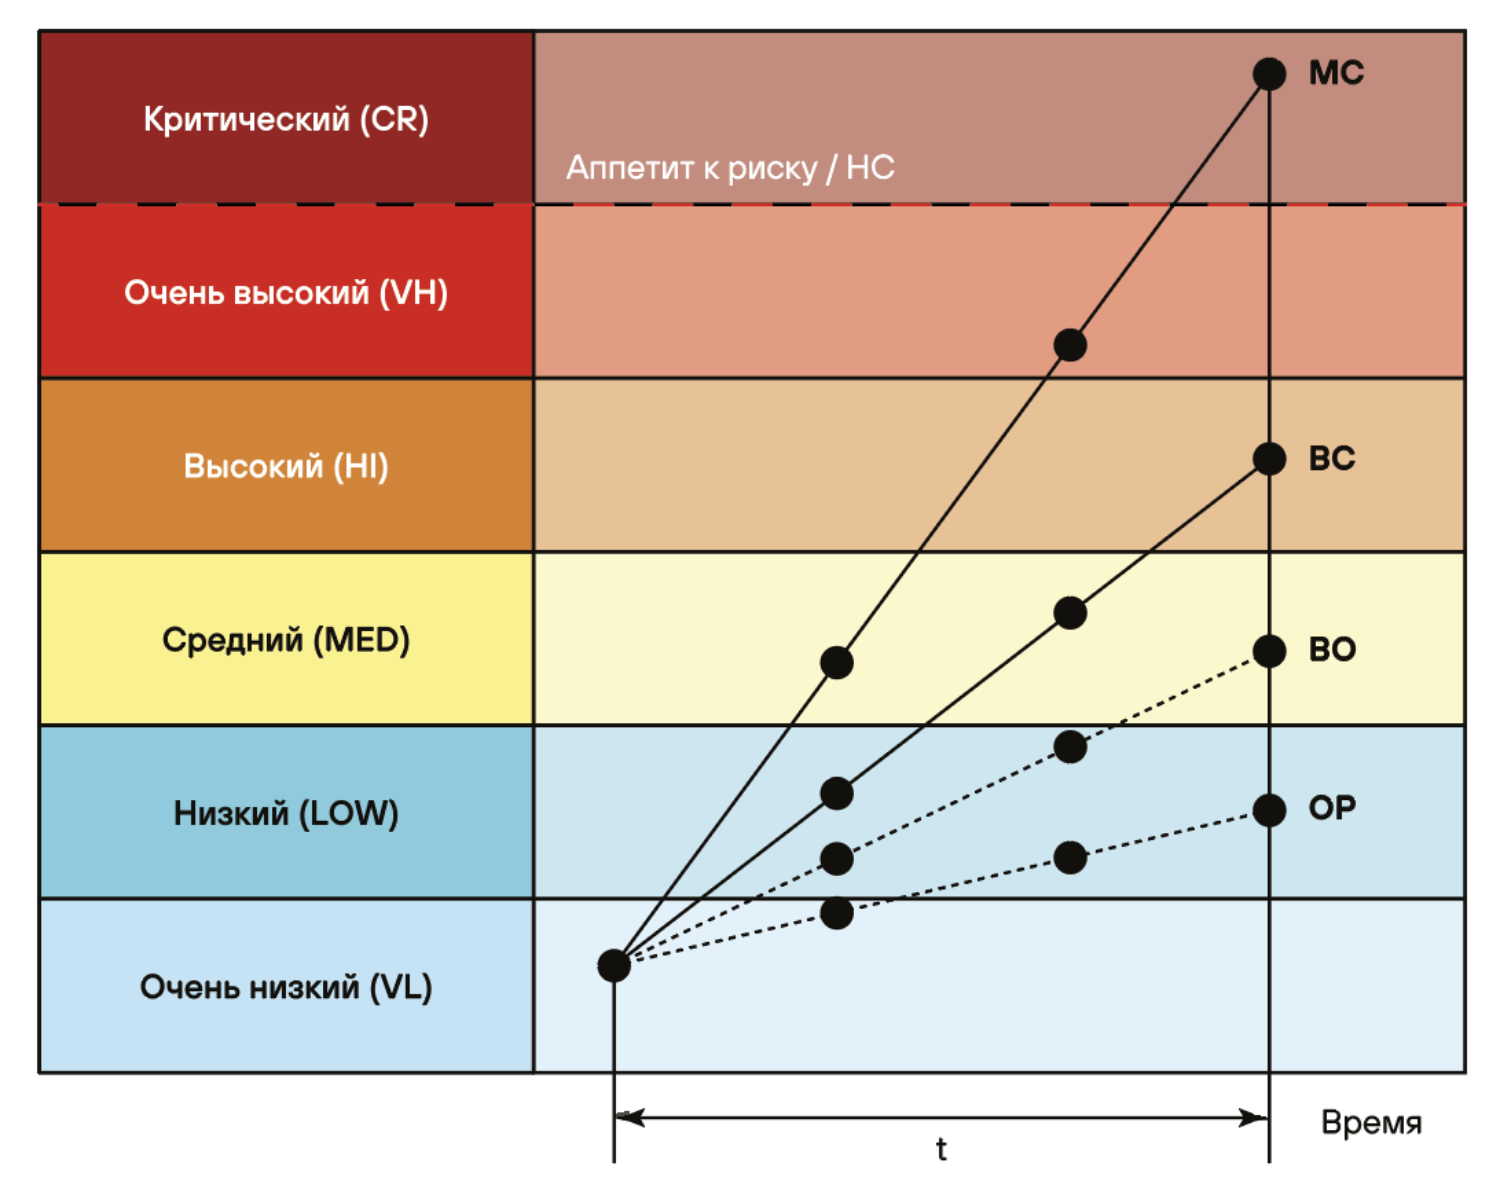
Как определить критичность инцидента
Критичность инцидента (которая также определяется последствиями) можно выразить через затронутые простоем системы. Давайте сделаем универсальную линейку, на которой укажем связь между затронутыми системами и критичностью инцидента.
Если рассматривать недопустимое событие как инцидент с наивысшим уровнем критичности, мы сможем сделать шкалу финансовых потерь, которая ассоциируется с инцидентами. Наш аппетит к риску или финансовая оценка НС будут нижней границей оценки потерь. Таким образом, мы можем градуировать влияние инцидентов, связанных с простоем систем, от нашего аппетита к риску и ниже. Градуировать такую шкалу лучше в логарифмическом масштабе.
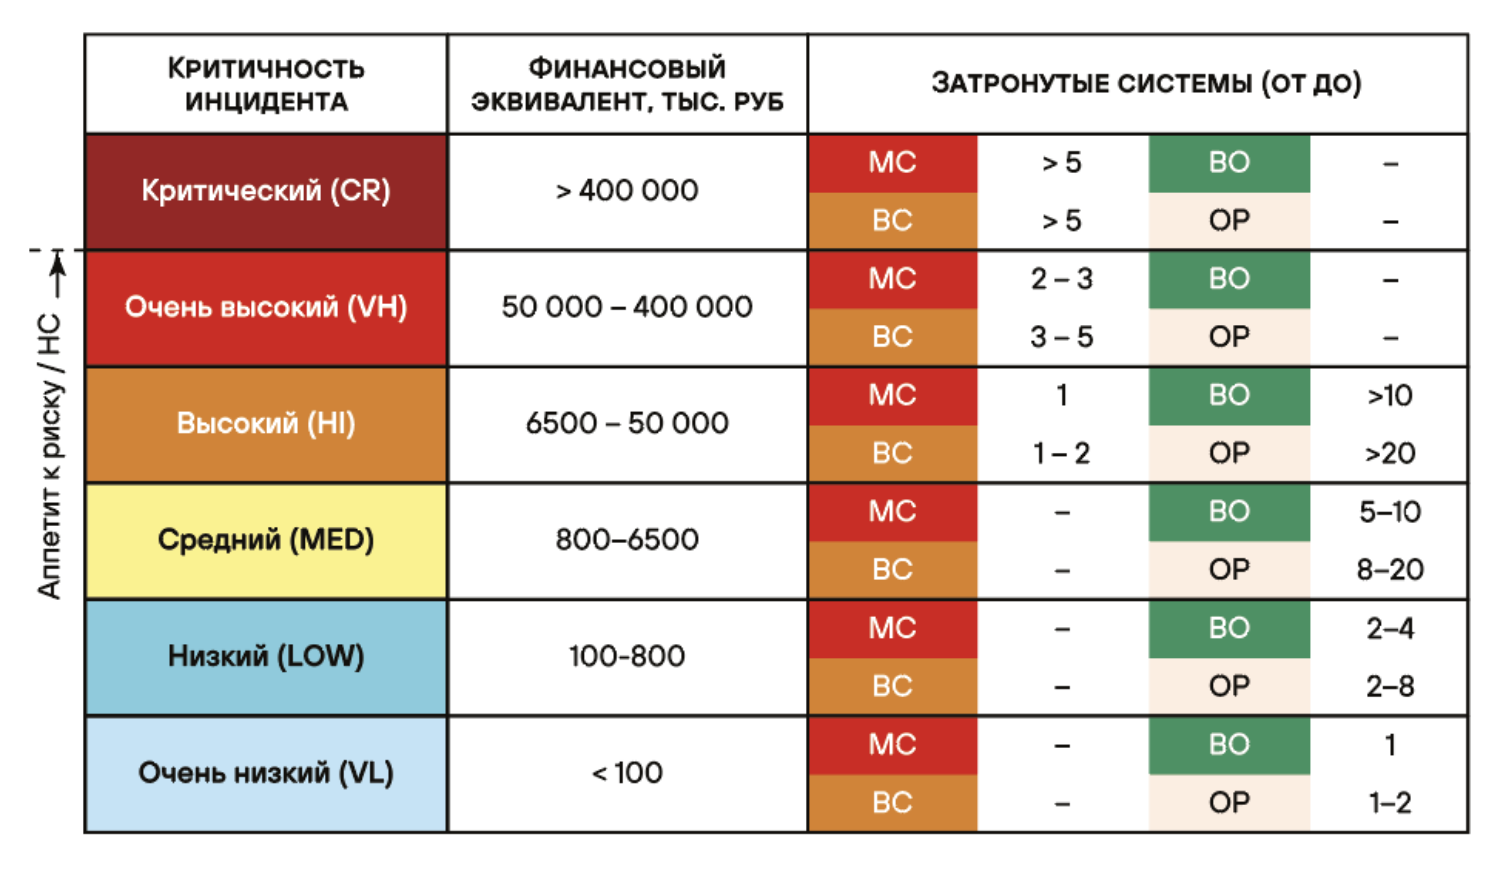
С помощью подобной таблицы можно оценить любой произошедший инцидент. По сути, такой же механизм может использоваться и в анализе операционных инцидентов, никак не связанных с ИТ или ИБ. Более того, ничто не мешает дополнить таблицу другими колонками: с критериями по конфиденциальности и целостности, с затронутыми рабочими станциями разных типов и т. д.
Как использовать методику в SOC
Казалось бы, совершенно очевидным путем будет анализ предотвращенных инцидентов. Вот система X, с ней мог произойти инцидент такой-то критичности, но этого не случилось из-за героических усилий SOC. Соответственно, мы записываем это в предотвращенный ущерб в соответствии с нашей таблицей (например, затронута одна система типа Mission Critical, денежный экививалент — 6,5 млн руб., записываем на счет SOC).
В чем минусы такого подхода:
- Инцидент все-таки мог случиться.
- При известных обстоятельствах стоимость предотвращенных инцидентов может легко превысить существенную часть стоимости активов организации (что вызовет безусловные вопросы у целевой аудитории метрики).
- Доверие к такой метрике будет невысоким.
- Поведение SOC меняется (закон Гудхарта — все инциденты становятся выше приоритетом, эффект кобры и пр.).
Что же можно сделать? Воспользоваться тем же принципом, но для реально произошедших инцидентов. Казалось бы, и здесь может сработать закон Гудхарта — все инциденты станут ниже приоритетом. Однако мониторинг простоя систем находится в ведении ИТ, а простоя бизнес-процессов — соответствующих отделов бизнеса. Аналогичным образом факт хищения денег, произошедший в результате ИБ-инцидента, будет замечен финансовым подразделением.
Теперь представим себе следующую метрику — сумму финансовых эквивалентов произошедших инцидентов за условный период времени для трех высших приоритетов (см. рис. 9).
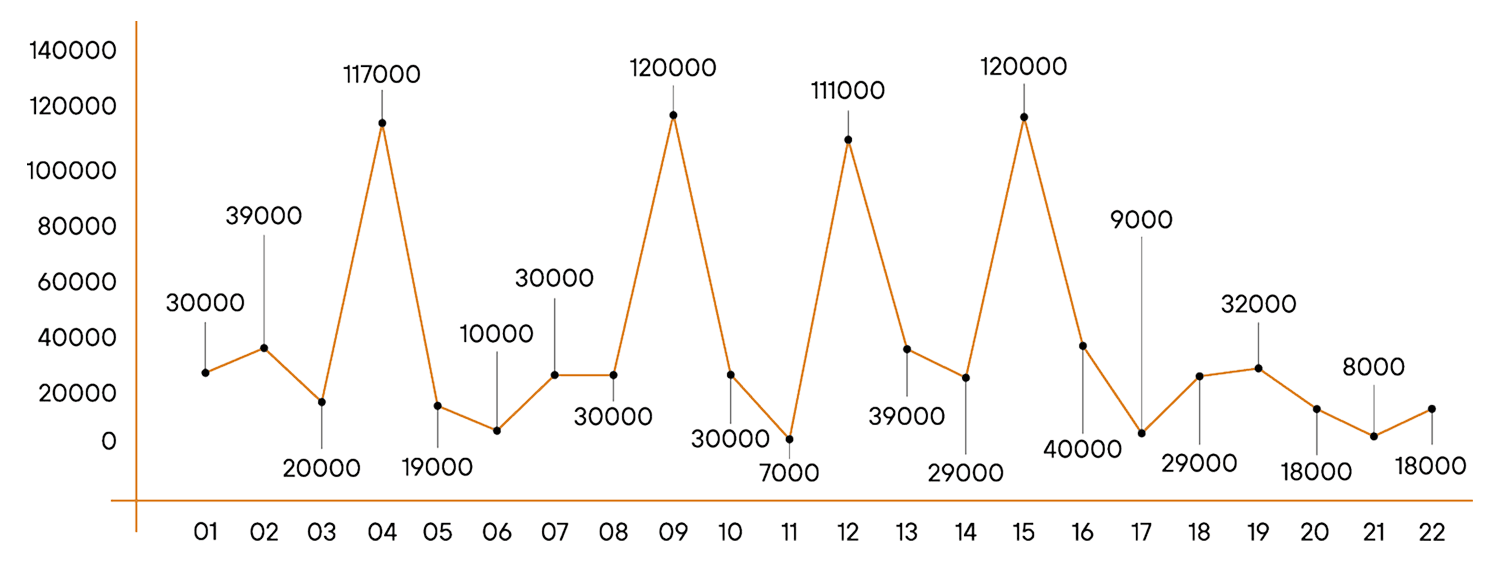
Мы видим график условных потерь за 22 условных месяца. Но абсолютная величина нам мало что говорит — нужно же с чем-то сравнивать. У нас уже есть следующее значение: аппетит к риску или нижний порог самого критического типа инцидента (он же — недопустимое событие).
Проведем красную черту, которая покажет это значение (см. рис. 10), и сравним его с суммой условных потерь за прошедшие 3 периода (обратите внимание, что график охватывает периоды 4–22, а не 1–22, как на рис. 9 выше).
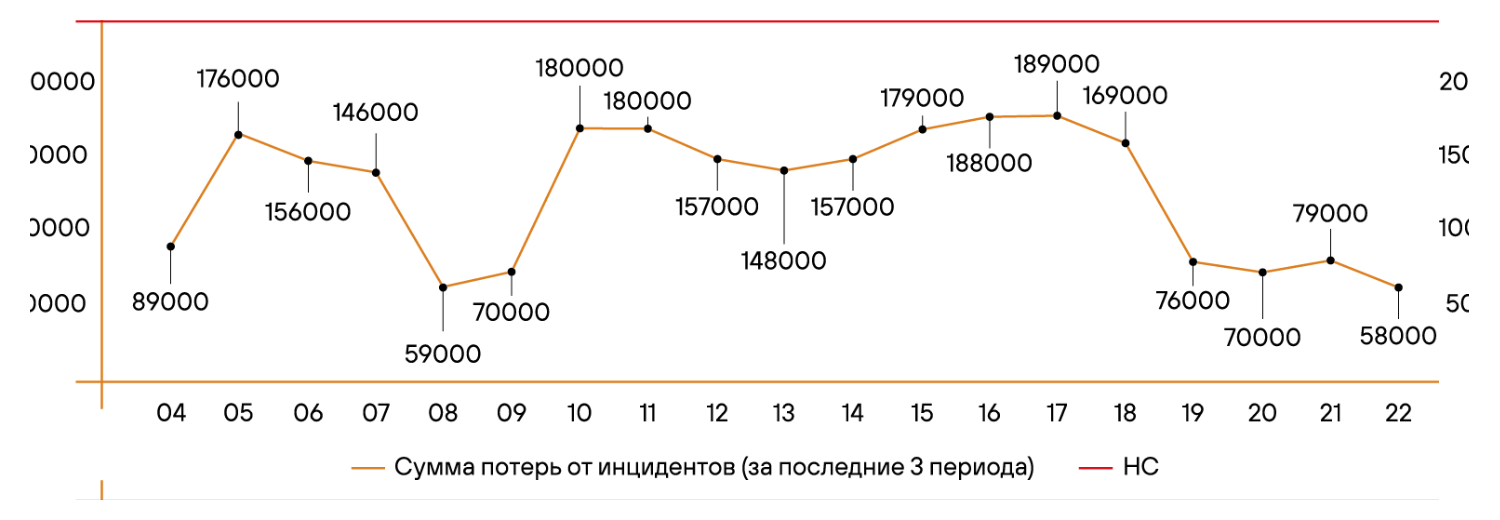
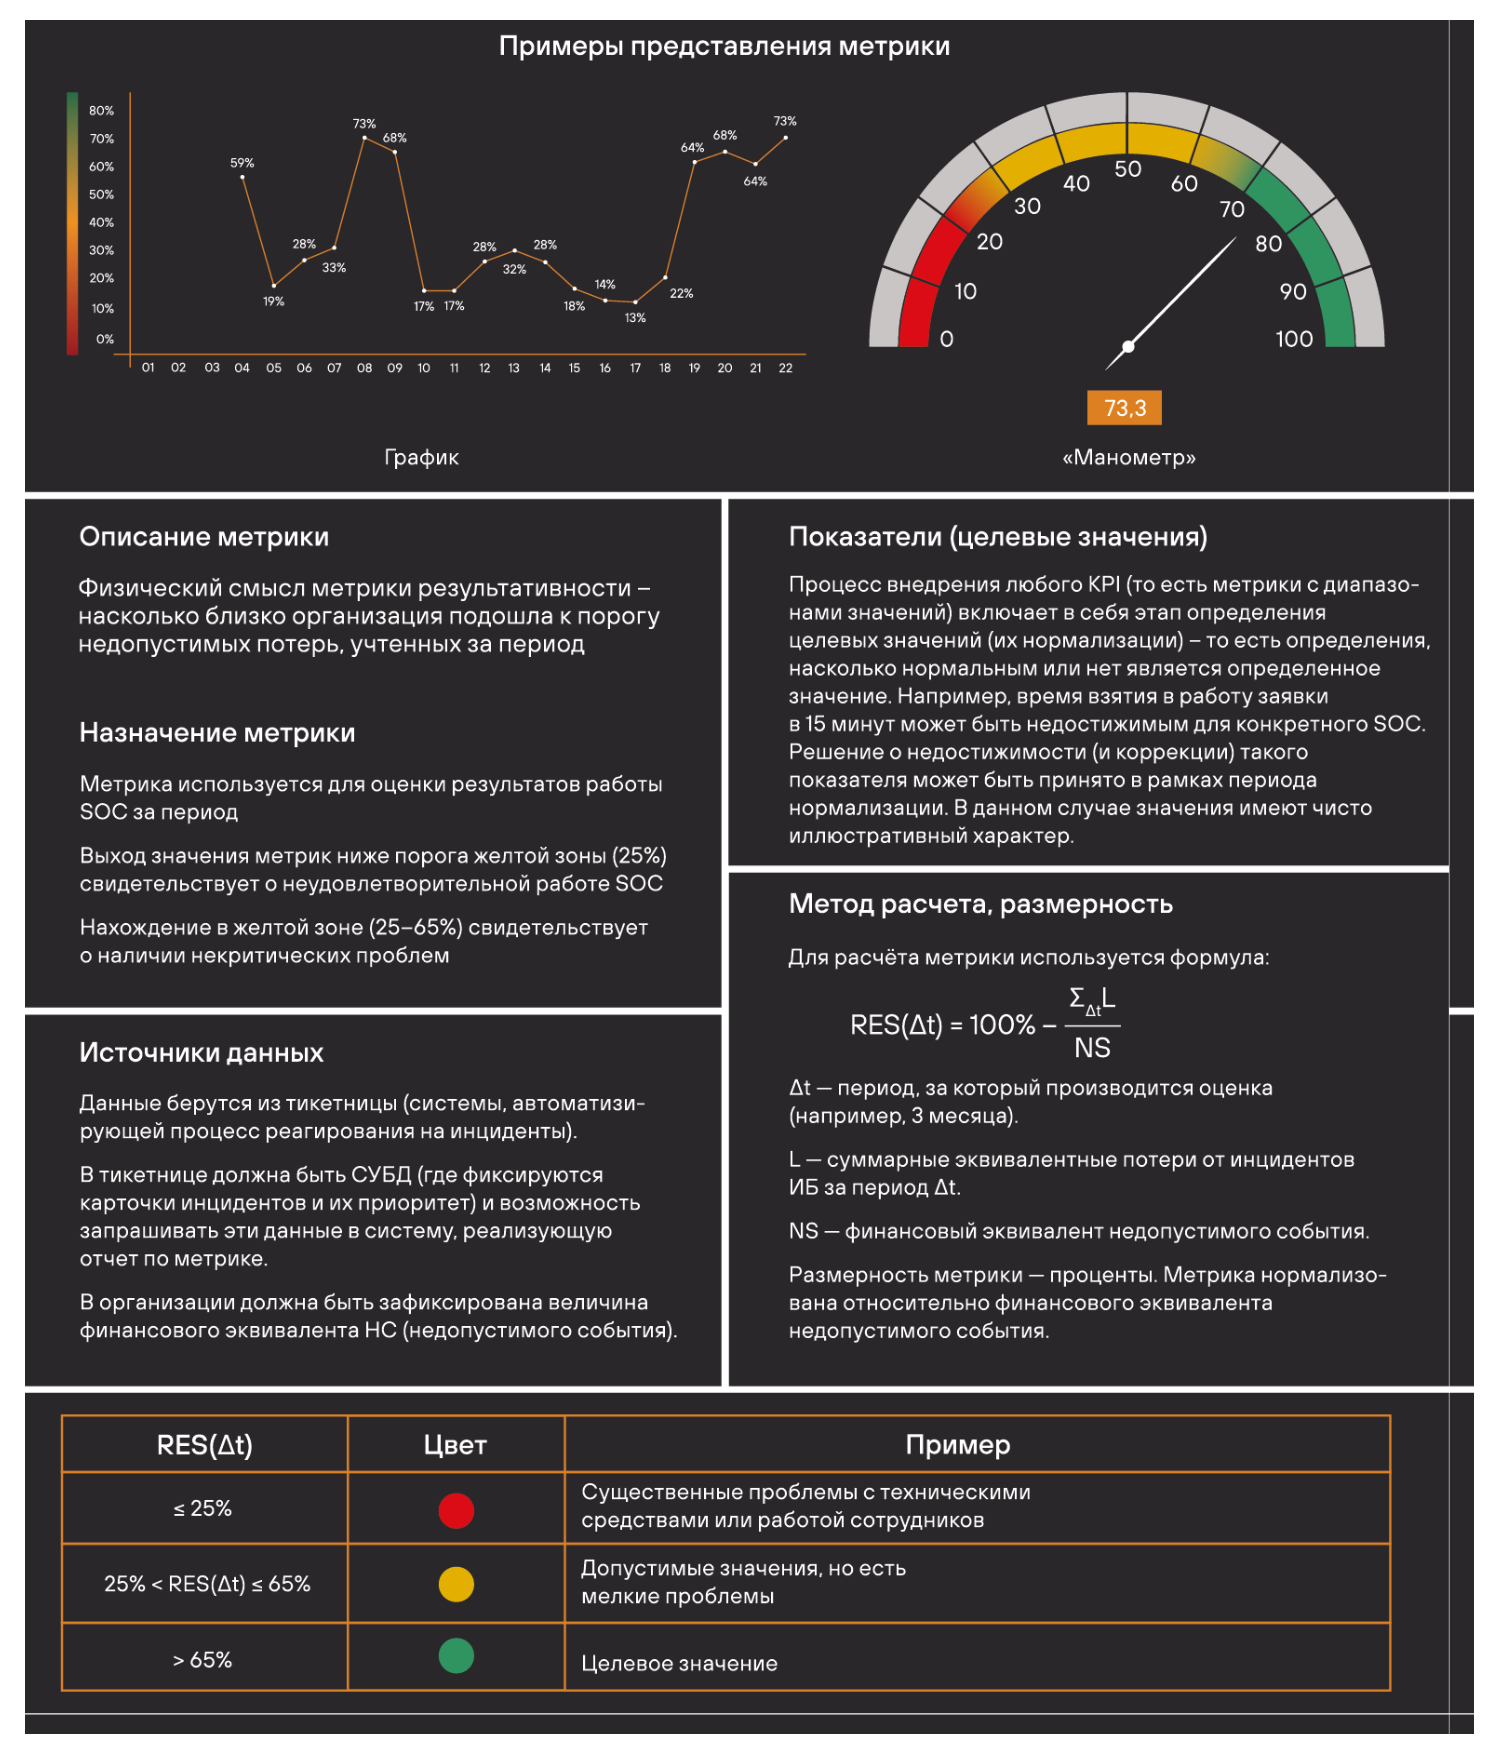
Что мы имеем: чем ближе значение подбирается к красной черте, тем хуже. Это означает, что SOC пропускает существенные инциденты. Самый простой виджет, который может это визуализировать, — манометр.
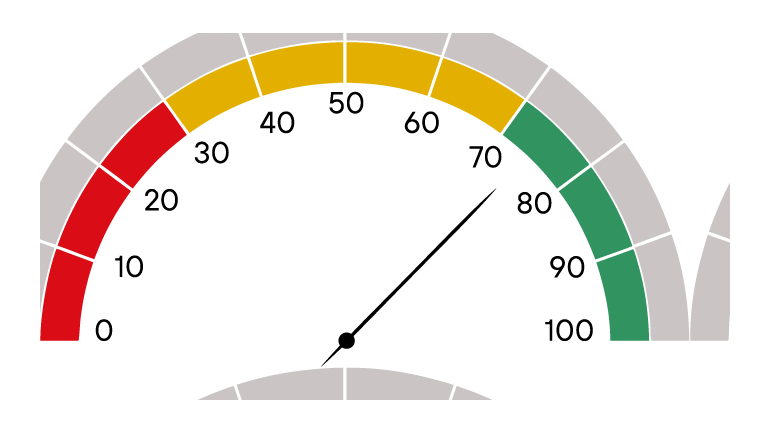
Если мы нормализуем значения относительно аппетита к риску, перевернем наш график и раскрасим его так же, как и шкалу манометра, то получится следующая картина — см. рис. 12. Чем дальше мы от НС, тем выше значение. Ноль произошедших инцидентов = 100% эффективности, а 0% эффективности означает, что мы дошли до недопустимого события.
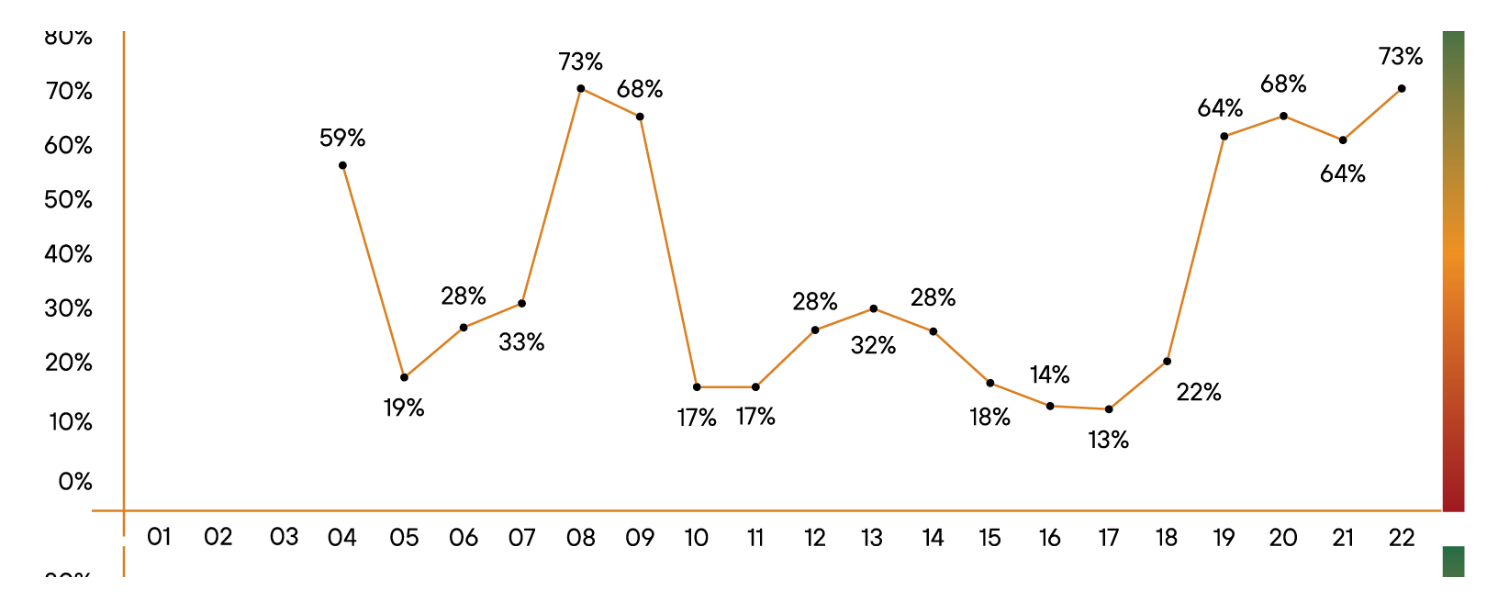
Этот график говорит на языке денег, который понятен любому руководителю организации. Соответственно, нашу метрику можно описать следующим образом (см. рис. 13).
[!IMPORTANT] Условия внедрения метрики
- Проведение организационной работы внутри компании — обсуждение аппетита к риску/НС, определение диапазонов потерь и критериев критичности инцидентов.
- Наличие автоматизированного процесса реагирования на инциденты, в котором они будут фиксироваться и ранжироваться, а также дашбордов с метриками по инцидентам.
- Налаженная связь между SOC и ИТ для фиксации простоев, связанных с ИБ-инцидентами.
Первые два условия в той или иной степени реализованы во многих компаниях. А выполнение третьего условия не является ни дорогой, ни сложной операцией, так как мониторинг доступности систем — хорошо устоявшаяся практика в ИТ.
***
Изложенная идея — это еще одна реплика в споре о метриках SOC и ИБ, и я ни в коем случае не претендую на истину в последней инстанции. Если эта статья подтолкнет вас к дальнейшему развитию метрик ИБ и даст хотя бы небольшой импульс к повышению эффективности ИБ-службы, значит, цель написания статьи достигнута.